Em uma integração que conecta um fluxo de KYC em empresa a outros sistemas, um erro de API é uma resposta ou falha que indica que algo saiu do esperado na requisição, na autenticação, em uma política de acesso, na rede ou no servidor.
Interpretar esse sinal corretamente reduz interrupções, retrabalho e tentativas de correção no lugar errado. O erro não é apenas um problema técnico: quando ele bloqueia cadastro, assinatura, validação ou consulta, vira também um problema de operação, experiência e custo.
Resumo
- Um erro de API deve ser lido a partir do código, da mensagem, da resposta e do contexto da chamada.
- Falhas 400, 401, 429 e 500 apontam para diagnósticos diferentes e não devem receber a mesma correção.
- CORS exige atenção ao console do navegador e à configuração de origem, cabeçalhos e preflight.
- Reproduzir a chamada, corrigir uma variável por vez e retestar torna o diagnóstico mais confiável.
- Taxa de erros, latência e padrões de requisição e resposta ajudam a transformar incidentes em melhoria contínua.
Como diagnosticar um erro de API sem adivinhar?
O erro que aparece na tela raramente conta a história inteira. Um bom diagnóstico começa pelo código de status e pela mensagem devolvida, mas continua nos headers, no corpo da resposta, no payload enviado, no console, nos logs e, quando houver, no trace da chamada.
Uma automação bem desenhada não pode depender de tentativa e erro informal. Se um fluxo falha, você precisa saber qual entrada gerou a falha, em qual etapa e com quais parâmetros.
Quando fundamos a ZapSign, tínhamos dois princípios muito claros: a solução precisava ser juridicamente válida e simples de usar. Eu aplico a mesma lógica às integrações. Uma API pode ser sofisticada por dentro, mas o time que a opera precisa receber sinais claros para entender o que aconteceu e agir rápido. Complexidade técnica que não se traduz em diagnóstico vira custo operacional.
O primeiro movimento, portanto, é preservar evidências. Registre o endpoint chamado, o método HTTP, o horário, o identificador da requisição, o status, a mensagem e os campos relevantes do payload, sempre sem expor segredos. Uma boa API de assinatura digital depende desse nível de observabilidade para que um problema não seja investigado apenas pela memória de quem viu o erro.
| Sinal | O que verificar | Hipótese inicial | Ação prática |
|---|---|---|---|
| Código HTTP | 400, 401, 429, 500 ou outro | Cliente, autenticação, limite ou servidor | Classificar antes de alterar a integração |
| Mensagem de erro | Campo, credencial, política ou serviço citado | Causa específica | Comparar com a requisição enviada |
| Payload | Tipos, nomes, campos obrigatórios e valores | Dado inválido | Corrigir somente o ponto inconsistente |
| Trace e logs | Etapa exata em que a chamada falhou | Falha de fluxo ou infraestrutura | Reproduzir em ambiente controlado |
O que os códigos 400, 401, 429 e 500 realmente dizem?
Os números só ajudam quando você respeita a semântica deles. O RFC 9110 define que respostas 4xx representam erros associados ao cliente, enquanto 5xx representam situações em que o servidor falhou ao atender uma requisição aparentemente válida. Isso muda a prioridade do diagnóstico: diante de um 400, faz sentido revisar parâmetros; diante de um 500, insistir em alterar o payload pode só mascarar a causa real.
O 400 Bad Request costuma apontar sintaxe, parâmetro ou formato incompatível. O 401 Unauthorized direciona a investigação para credenciais, token, expiração ou formato de autenticação. A própria documentação do Login Único diferencia esses retornos e também classifica o 429 como excesso de requisições e o 500 como falha interna do servidor. A decisão correta depende menos de decorar códigos e mais de conectá-los ao contexto.
O 429 Too Many Requests merece cuidado porque muitas equipes o tratam como instabilidade. Não é a mesma coisa. Se existe um limite de requisições, o cliente precisa respeitar a política, controlar concorrência e definir uma estratégia de nova tentativa que não aumente o congestionamento. Já o 500 pede registro consistente, correlação por identificador e análise do lado do serviço. Repetir chamadas indefinidamente é uma forma de transformar um erro pontual em outro problema.
A segurança também entra no desenho da resposta. A OWASP recomenda códigos semanticamente adequados e orienta que mensagens de erro não exponham informações internas, como stack traces detalhados. Isso cria um equilíbrio importante: a API precisa informar o suficiente para o consumidor corrigir a integração, mas não deve abrir detalhes que ampliem a superfície de ataque.
Confira também estes conteúdos relacionados:
- Entenda como uma documentação de API organiza autenticação, respostas, exemplos e limites de uso.
- Veja como a ZapSign API conecta documentos, signatários, status e webhooks a outros sistemas.
- Conheça diferentes formas de integrar a ZapSign a fluxos e ferramentas corporativas.
CORS: quando o navegador vira parte do diagnóstico
Nem todo erro percebido no front-end nasceu na API. Em chamadas feitas pelo navegador, uma política CORS mal configurada pode bloquear o acesso à resposta mesmo quando o servidor recebeu e processou parte da requisição. Nesse caso, olhar apenas para o JavaScript é insuficiente. O diagnóstico precisa comparar origem, método, cabeçalhos permitidos, credenciais e o comportamento da requisição preflight.
Eu voltei recentemente de uma imersão em inovação na Estônia com uma pergunta que considero muito útil para produto: como reduzir fricção sem sacrificar confiança? CORS mostra bem essa tensão. Liberar origens sem critério pode resolver o teste de hoje e criar um problema de segurança amanhã. Bloquear tudo, por outro lado, inviabiliza a experiência. A configuração certa precisa ser explícita e coerente com a arquitetura.
Por isso, reproduza a falha no navegador, abra as ferramentas de desenvolvimento e examine console e aba de rede. Compare a chamada com uma execução fora do navegador, por exemplo em um cliente de API. Se a requisição funciona fora dele e falha no front-end, a política de origem ganha peso na hipótese. Esse raciocínio evita culpar autenticação ou payload quando o bloqueio está em outra camada.
Esse cuidado também se conecta com a segurança da ZapSign e com a lógica de validação de identidade: segurança não é adicionar obstáculos aleatórios, e sim aplicar controles que façam sentido para o risco. Em integrações, a mesma regra vale para origem, credenciais, permissões e tratamento de falhas.
Como testar, retestar e medir uma integração
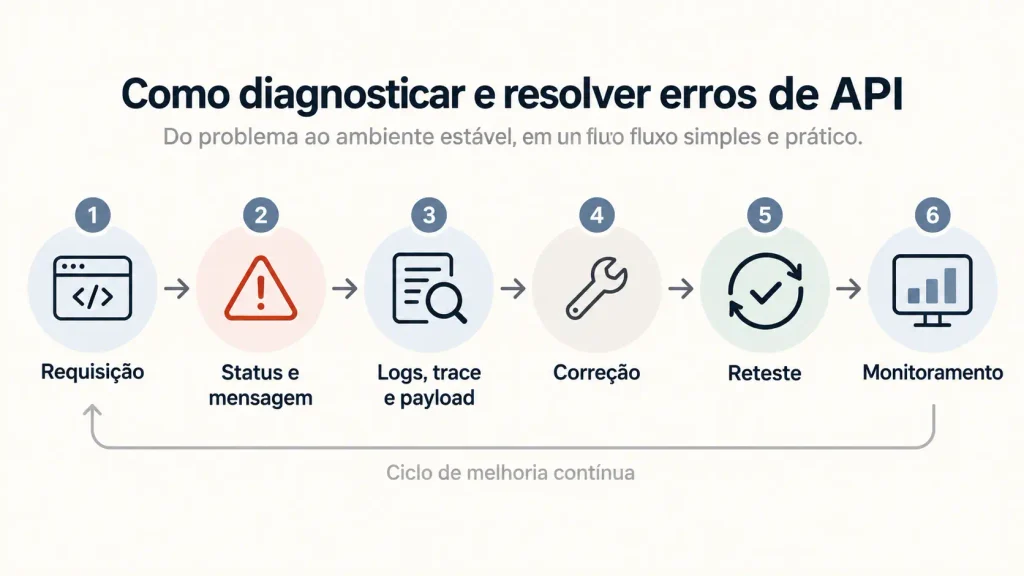
Depois de formular uma hipótese, reproduza a chamada em condições controladas. Mantenha o endpoint, o método e o contexto e altere uma variável por vez. Se o erro for 400, revise o campo apontado, o tipo do dado, os parâmetros obrigatórios e o formato do corpo. Se for 401, valide token, cabeçalho e expiração. Se for CORS, corrija a política do servidor. O reteste deve provar a causa, não apenas fazer a mensagem desaparecer.
Em produto, eu tenho preferência por transformar o complexo em algo simples de testar e operar. Foi esse raciocínio que também apareceu no lançamento do ID ZapSign: permitir que equipes validem uma hipótese por API sem criar uma jornada burocrática antes do primeiro teste. Para mim, uma boa integração segue essa lógica: reproduzir, medir, corrigir e testar de novo precisa ser um ciclo curto.
Não pare no teste funcional. A integração precisa ser observável em produção. Acompanhe taxa de erros, latência, volume de chamadas, distribuição por status e padrões de requisição e resposta. Ferramentas de monitoramento de APIs também usam justamente error rate, latência e comportamento do tráfego para revelar degradações e endpoints problemáticos. O indicador só tem valor quando gera uma decisão: corrigir código, ajustar capacidade, rever limite ou melhorar o contrato da API.
| KPI | O que revela | Pergunta de gestão |
|---|---|---|
| Taxa de erros | Proporção de chamadas que falham | O problema é isolado ou recorrente? |
| Latência | Tempo de resposta | A integração está degradando a jornada? |
| Status por classe | Concentração de 4xx e 5xx | A correção depende mais do cliente ou do serviço? |
| Padrões de requisição | Picos, repetição e combinações problemáticas | Há abuso, retry mal calibrado ou erro de desenho? |
Esse acompanhamento se torna ainda mais relevante quando a API participa de uma jornada de assinatura eletrônica, porque uma falha técnica pode bloquear uma ação com prazo, cliente e impacto jurídico envolvidos. A operação deve saber quando o erro começou, quem foi afetado e qual foi a resposta adotada.
Um erro API bem tratado vira melhoria de produto
Registrar, diagnosticar e retestar de forma disciplinada muda a relação da empresa com incidentes. O objetivo não é criar uma operação em que nunca exista falha; é impedir que a mesma falha volte sem explicação. Uma equipe que conecta logs, códigos, payloads, métricas e contexto de negócio aprende mais rápido e reduz o tempo entre sintoma e correção.
Também vale revisar periodicamente o contrato da integração, a autenticação, as políticas de acesso e os pontos em que uma chamada pode falhar. Em fluxos digitais, a assinatura de documentos e outras ações críticas dependem de sistemas que conversem de forma previsível. A melhoria contínua começa quando o erro deixa de ser um evento isolado e vira dado para engenharia, produto e operação.
Se a sua empresa está construindo fluxos que dependem de validação, autenticação e decisões por API, vale estruturar esse diagnóstico desde o primeiro teste. Conheça o ID ZapSign para testar verificações de identidade em uma infraestrutura pensada para integração. Quanto melhor você entende cada erro de API, mais previsível fica a evolução do produto.
Perguntas frequentes (FAQ)
Um erro de API indica que uma requisição não produziu a resposta esperada por causa de parâmetros, autenticação, políticas de acesso, limites, rede ou falha do servidor. O código HTTP ajuda a classificar o problema, mas o diagnóstico deve considerar também a mensagem, o corpo da resposta, o payload enviado, os logs e o contexto da chamada.
Comece comparando o payload enviado com a documentação do endpoint. Verifique campos obrigatórios, tipos de dados, parâmetros, formato do corpo e valores aceitos. Depois, reproduza a mesma chamada em um ambiente controlado e altere apenas o ponto suspeito. Se a resposta mudar após uma correção específica, você ganha evidência de que encontrou a causa em vez de apenas contornar o sintoma.
O 401 Unauthorized aponta para um problema de autenticação, como credencial ausente, inválida ou expirada. Já o 429 Too Many Requests indica que a quantidade ou frequência de chamadas ultrapassou uma política de limitação. A correção, portanto, é diferente: no 401 você revisa credenciais e cabeçalhos; no 429 você controla volume, concorrência e estratégia de novas tentativas.
Reproduza a chamada no navegador e consulte o console e a aba de rede. Depois, compare o comportamento com uma chamada equivalente feita fora do navegador. Se a API responder normalmente fora dele, revise origem permitida, métodos, cabeçalhos, credenciais e preflight. A correção geralmente depende da configuração do servidor, e não apenas do código JavaScript do cliente.
Taxa de erros, latência, volume de chamadas, distribuição por códigos HTTP e padrões de requisição e resposta formam uma base útil. O ideal é analisar esses indicadores junto do impacto no processo de negócio. Um aumento de 5xx, por exemplo, pode exigir investigação de infraestrutura; uma concentração de 4xx pode apontar integração mal configurada ou validação insuficiente no cliente.

Getúlio Santos é CEO da ZapSign, advogado, entusiasta de tecnologia e empreendedor.